В статье раскроем нюансы продвижения сайтов на технологии SPA (сайты, построенные полностью на JavaScript). Single Page Application – приложение одной страницы.
Почему эта тема актуальна?
В интернете часто обсуждают вопрос о том, можно ли подружить сайты созданные на JavaScript с поисковой системой. Существует много слухов о том, что JavaScript не индексируется поисковой системой, поэтому важно развеять или утвердить этот миф.
Из данной статьи вы узнаете, как подружить сайт на JavaScript с поисковой системой, чтобы он индексировался и высоко ранжировался.
Кому будет полезна данная информация?
- владельцам бизнеса, маркетологам (экономия от 300-500 тысяч на разработку);
- SEO-специалистам (изучите опыт в продвижении данных ресурсов);
- программистам (поймете особенности как сделать сайт, чтобы он продвигался в поисковой системе).
Видео
Презентация
Типы сайтов
Для удобства можно разделить сайты на:
- статический сайт – HTML;
- частично динамический – AJAX;
- динамический сайт – JS (SPA).
Классические HTML сайты
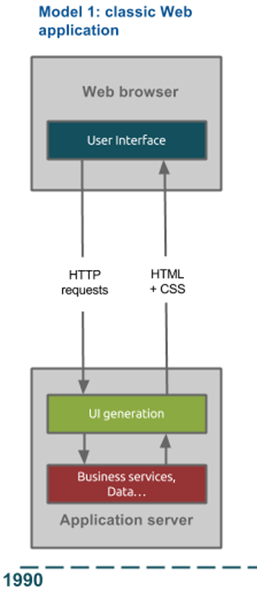
Классические сайты – те, с которыми чаще всего сталкивается любой пользователь в интернете. Браузер отправляет HTTP запрос на сервер и просит сервер «показать» ему HTML + CSS. Сервер отправляет данные, а браузер отрисовывает их.
Сайты, построенные на AJAX
Работают по тому же принципу, что и первая модель, но прибавляется JavaScript. С помощью него прогружаются интерактивные элементы внутри страницы. Например, в интернет-магазине можно прогрузить сортировку товаров или фильтры без перезагрузки страницы.
Сайты, построенные на SPA технологии
Полностью интерактивный сайт, построенный на JavaScript.
Далее рассмотрим детально нюансы каждого вида сайтов.
Статический сайт – HTML:
- Частая перезагрузка страниц — каждый раз, когда пользователь обращается к какой-либо странице, браузер отправляет запрос к серверу и она вынуждена перезагружаться.
- Скорость загрузки — в связи с постоянной перезагрузкой файлов, скорость загрузки ниже, по сравнению с другими методами).
- Ограниченная функциональность — нет интерактива, возможного при использовании JS.
Частично динамический сайт — AJAX
AJAX – использование технологий JS и XML.
- Частичная перезагрузка страницы — например, в интернет-магазине можно организовать сортировку товаров уже без перезагрузки страницы.
За счёт этого обеспечивается:
- Более быстрое взаимодействие с пользователем.
- Расширенная функциональность благодаря JavaScript.
Динамический сайт -> SPA
- Нет перезагрузки страниц — внутри сайта всё изменяется на JavaScript.
- Быстрое взаимодействие с пользователем — пользователь не ждёт перезагрузки страницы, контент обновляется динамический.
- Наиболее расширенная функциональность по сравнению с предыдущими видами.
Как организован SPA сайт?

Наш клиент (браузер) отправляет запрос серверу. Сервер первый раз отдаёт HTMLстраничку. Далее всё взаимодействие строится на JavaScript. Для удобства разработки существует JavaScript Framework’и. Фреймворк — ПО, облегчающее разработку сайта.
Наиболее популярные Фреймворки:
- Angular
- React
- Ember
- Polymer
- Meteor
- Backbone
- Vue
- Knockout
В чём основная сложность для поисковой системы в таких сайтах?
Поисковая система не умеет обрабатывать JavaScript сайты. Чтобы обработать JS, требуется JavaScript перевести в HTML, тогда ПС сумеет провести индексацию. Название этой процедуры – рендеринг. Рендеринг JavaScript – это отрисовка JavaScript в HTML формате.
Что говорят поисковые системы о сайтах на JS:
Яндекс утверждает, что умеет рендерить самостоятельно, но только в рамках теста, выборочно и только для некоторых сайтов. Большинства сайтов Яндекс рендерить не умеет! Поэтому, вам необходимо настроить внутренний рендеринг сайта, чтобы Яндекс начал «понимать» его.
Google умеет самостоятельно рендерить страницы, с помощью WRS. WRS – специальная технология рендиринга на основе браузера Google Chrome. При помощи Google Webmaster, вы можно проверить, как Googlebot отрисовывает ваш сайт.
Компания MOZ провела исследование и выясняла, умеют ли поисковые системы обрабатывать JS используемые в популярных Фреймворках и составила сводную таблицу. Выяснилось, что лишь Google и Ask (на основании технологии поиска Google) умеют, а остальные поисковики – нет.

Рассмотрим основные этапы работы поисковых систем, где могут возникнуть сложности с SPA.
- Сканирование.
- Индексирование.
- Ранжирование.
Этап 1. Сканирование
Есть поисковой робот (сканер), находит все страницы в интернете и «собирает» оттуда только URL’ы страниц.
Основные задачи:
Найти, сохранить и передать URL’ы. Всё, что находится в <a href=“…”>, он копирует себе в базу, упорядочивает и передаёт данные следующему роботу-индексатору.
- Определить приоритеты сканирования (на какие страницы нужно заходить чаще и проверять обновления, на какие реже).
Сканер не занимается рендерингом (т.е. не может разобрать контент с использованием SPA технологии).
Этап 2. Индексирование
Основные задачи:
- Обойти и обработать URL’ы, которые передал робот-сканер.
- Сохранить всё в индексную базу.
Данный робот занимается рендерингом и умеет это делать.
Пример работы сканера и индексатора
Взаимодействие на HTML сайтах:
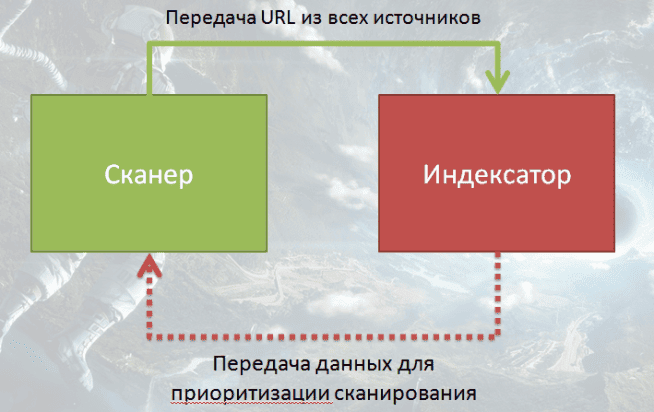
Сканер выкачивает URL’ы, передаёт индексатору. Индексатор часть данных отдаёт обратно для приоритезации.
Сложность взаимодействия со SPA сайтами:
Сканер не может обрабатывать URL’ы, которые нашёл на страницах, так как не умеет рендерить. Индексатор берёт на себя ключевую роль сканера. Ему необходимо сначала страницу прогрузить, после узнать о ссылках, которые есть, и только потом он может переходить на следующую страницу. То есть процесс сканирования и индексирования сайта очень сильно замедляется.
Сложность: робот-сканер может обрабатывать только HTML страницы и находить URL’ы в них. Индексатор вынужден всё время рендерить страницы, чтобы получить новую порцию ссылок для робота сканера и передавать их.
Вывод
Основные сложности в обработке сайтов на JS возникают в 2 процессах:
- Процесс сканирования и переобхода страниц.
- Построение графа внутренних ссылок. Граф ссылок может использоваться для определение важных и неважных страниц, а так же каноникализации — определение оригинальных и дублированных страниц.
Например, у нас есть дублированные страницы. Робот прогрузил и видит rel=»canonical» на другую страницу, но на вторую страницу он не зашёл и не знает о информации размещенной на ней, так как не хватило лимита краулингового бюджета.
Краулинговый бюджет – каждому сайту выдаётся определённый лимит на индексацию. Условно – времени работы поисковых роботов, которые обходят сайт. Чем популярнее сайт, чем больше он имеет внешних ссылок, тем больше лимитов предоставляется от поисковой системы.
В SPA сайтах краулинговый бюджет «страдает», так как роботу приходиться прилагать «больше усилий», чтобы обработать сайт.
Решение
Так как Яндекс не умеет рендерить, необходимо это делать за него.
Методы рендеринга JS:
- Рендеринг на аутсорсе.
- Рендеринг на своих серверах.
- Рендеринг на стороне ПС.
Рендеринг на аутсорсе
Можно отдать эту задачу стороннему серверу типа prerender.io.
Минусы:
- зависимость от внешних ресурсов (неизвестно, насколько корректно сделает);
- дороговизна при больших объёмах (за каждую страницу свыше 200 бесплатных – нужно платить деньги).
Рендеринг на своих серверах
- С помощью Headless браузера.
- PhantomJS , HTML Unit
- Фраймворк с пререндерингом.
- React, Angular
Минусы:
- высокая нагрузка на сервер — обработка как всех посетителей, заходящих на сайт, так и роботов: нужно держать вторую версию сайта в HTML формате. Из-за этого возникает большая нагрузка, а чем её больше, тем больше платим;
- постоянный мониторинг за кодом ответа сервера, если сервер перегрузится, начнёт выдавать 500 ошибку, страница начнёт вылетать с индекса, следовательно, пользователи перестанут заходить на сайт. Тестирование при всех доработках (на 2 версиях сайта: JS и HTML).
Рендеринг на стороне поисковой системы
Минусы:
- Умеет только Google, но если Яндекс не важен, то можно отдать на откуп ПС (подходит для Буржунета).
- Возможна некорректная обработка, нужен мониторинг за рендерингом и обработкой (просмотр страниц в качестве GoogleBot).
- Сложности при сканировании SEO сканерами (умеет NetPeak Spider).
Выводы по методам рендеринга JS
- Если у вас небольшой сайт используйте аутсорс (до 200 страниц).
- Если не нужен Яндекс и небольшой сайт – отдайте на откуп Google.
- Если большой сайт — используйте свои серверы.
Как передавать HTML код роботу, чтобы поиск о нём узнал?
Существует 3 метода передачи HTML кода.
- Escape fragment.
- Определение поискового робота по user-agent.
Не передаем(не рассматриваем, так как Яндекс в России нужен).
1 метод. Использование — Escape fragment
- # => #! => ?_escaped_fragment_=
- Есть домен: http://www.example.com/#blog
- Мы переводим такие URL’ы в: http://www.example.com/#!blog
- Поисковой робот начинает «видеть» такие URL’ы и будет переходить по ним в: http://www.example.com/?_escaped_fragment_=blog
По данному адресу у нас должна располагаться полностью отрендеренная HTML страничка.
Как альтернативное решение используется:
<meta name=»fragment» content=»!»>
Минус – данная технология является устаревшей по мнению Google, так как он научился рендерить с помощью технологии WRS и браузера. Однако для Яндекса технология продолжает оставаться актуальной.
2 метод. Определение по User-agents
- Определяем, что к нам пришёл GoogleBot / YandexBot
- Смотрим IP, который они отдают
- Определяем домен с помощью reverse DNS lookup.
Нужно опознать, действительно ли зашёл робот ПС, или это сканер шифруется под него и хочет нагрузить наши сервера.
По ссылке вы можете найти информацию о том, как это можно сделать: https://yandex.ru/support/webmaster/robot-workings/check-yandex-robots.xml
- Отдаём HTML версию
Что делать, если зайдёт робот «с усами»?
«Робота с усами» мы называет поискового робота, который проверяет сайт на клоакинг.
Клоакинг – это когда поисковой системе отдаётся один контент, а живому пользователю – другой, то есть производится подмена контента. Это «черная» технология продвижения и поиск борется с этим.
Наша задача, определить по User-agent поискового робота и отдать ему HTML формат, а пользователям – JS, в случае если контент идентичный, Яндекс/Google не будет иметь претензий, так как клоакинга нет.
Как учитываются поисковые факторы?
В Яндексе они наиболее актуальны, чем в Google. Однако на этот вопрос нет однозначного ответа, так как пользователи фактически изучает сайт на JS, а роботы – на HTML, соответственно они находятся на различных страницах.
Наше мнение, что основным поведенческим фактором является внешние поведенческие факторы в SERP.
Для сбора корректной статистики и учета всех возможных факторов, мы рекомендуем внести дополнительные настройки:
Что такое хорошее SEO?
SEO => упрощение работы поисковым системам.
Задача оптимизатора:
- Ускорить сканирование
- Упростить индексацию
- Усилить ранжирование
- структура сайта
- состав страницы
- доверие и авторитет
Технология SPA сайтов усложняет работу поисковых систем, так как «страдает» процесс индексирования, и приходится рендерить страницы, собирать отдельно статистику.
Пример реального продвижения SPA сайта
Кейс: сайт-агрегатор одежды.
На сайте более 3 млн. страниц, каталог имеет наполнение:
- 100 интернет-магазинов
- 20 000 брендов одежды
- 3 млн. товаров
Монетизация — заработок на комиссии с продаж по партнёрским программам интернет-магазинов.
Используемые технологии:
AngularJS и за счёт PhantomJS — передаётся JS и обрабатывается в HTML.
Передача HTML происходит с помощью рендеринга по User-agent.
Мы определяем, кто запрашивает страницу, если это GoogleBot или YandexBot, мы отдаем ему версию HTML.
У сайта изначально была плоская структура: главная страница и подразделы.
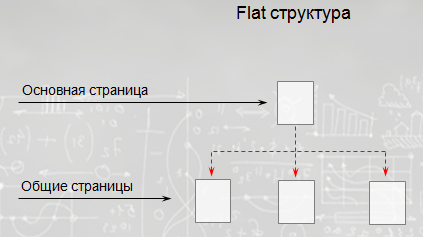
Структура не разветвлённая, созданы только общие разделы:
Основные этапы продвижения:
- Собрали объемную семантику;
- Спроектировали структуру на её основе;
- Провели технические работы по подготовке к сканированию и индексации;
- Размещение ссылок на сторонних ресурсах.
Технический аудит положил начало работе. В процессе найдено около 230 ошибок, в связи с чем программистам пришлось вносить множество доработок и приводить к стандартам требуемыми поисковыми системами.
Далее мы проанализировали спрос, разобрали пользовательские интересы, провели группировку запросов и построили новую структуру, состоящую из категорий, подкатегорий; признаков и свойств и конечных посадочных страниц.
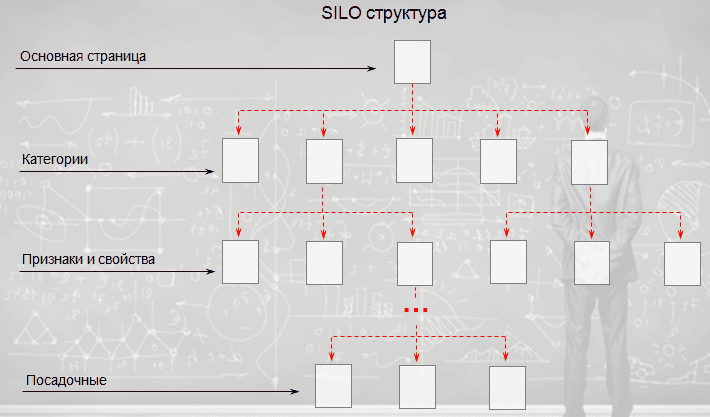
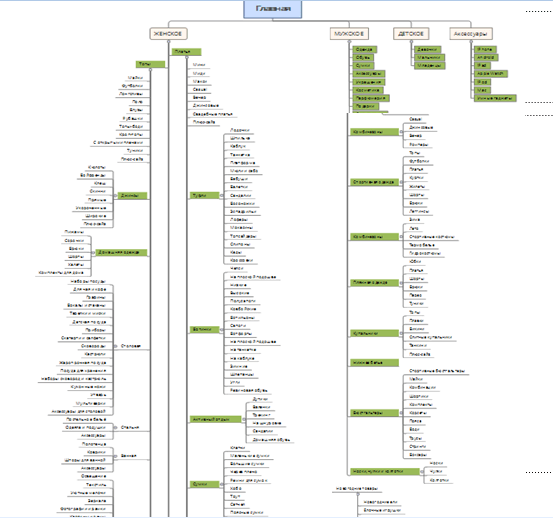
Мы применили технологию оптимизации при помощи SEO фильтров.
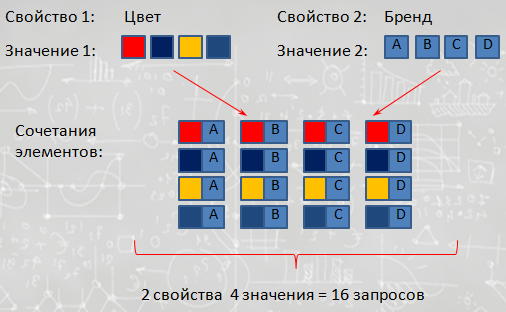
Благодаря очень раздробленной структуре и проработке всех потребностей пользователя — получили максимальный охват аудитории.
Основная сложность проекта
Крайне сильно «страдала» индексация новых посадочных страниц.
В тематике одежды преимущественно категорийный спрос, то есть люди ищут, например, «кроссовки Adidas» и в меньшей степени конкретные артикулы.
В ходе продвижения мы настроили индексацию таким образом, чтобы специально исключить незапрашиваемые карточки товаров. Улучшили индексацию на категорийных страницах, и трафик начал расти.
Итог по этому кейсу: рост трафика в 7 раз за 4 месяца.
Вывод о сайтах на SPA:
SPA технология – отличный инструмент, который позволяет сделать много полезного для пользователей.
Её основное применение в основном для внутренних сервисов, где не потребуется индексирование страниц, но нужен интерактив для пользователей.
Мы уже убедились на практике, что применяя SPA можно создавать сайты для продвижения, но в этом случае возникают большие сложности поисковых алгоритмов.
Что вы думаете относительно этой темы? Давайте обсудим в комментариях!
Автор: Миндубаев Рамазан – руководитель команды SEO в TRINET.Group.
Материал проверен редактором

Head of SEO в интернет-агентстве TRINET.Group
в SEO более 11 лет,
автор книги «Светлая сторона продвижения сайтов»,
организатор конференции SeoClubSpb.
20.02.2020